标签: DeepSeek DeepSeek-OCR 2 OCR模型 文档识别
云梦级1月27日云梦级消息,DeepSeek 今日公布了其最新一代文档识别模型 DeepSeek-OCR 2。很显然,该模型是在 DeepSeek-OCR 的基础上升级而来,核标签心变化集中在视觉编码器设计上。 研究团队提出了一种名为 DeepEncoder V2 的新型编码器结构,它能够根据图像语义动态调整视觉信息的处理顺序,使模型在进行文字识别前先对: 视觉内容进行智能排序。这项技术突破源于对传统视觉语言模型处理方式的重新思考,旨在让机器更贴近人类的视觉阅读逻辑。 在传统的视觉语言模型中,图像通常会被切分为若干视觉 token,De并按照从左上到右下的固定栅格顺序送入模型处理。这种方式虽然实现简单,但与人类在阅读文档、表格或公式时基于语义和逻辑关系进行跳跃式浏览的方式并不一致。 DeepSeek 论文指出ep,尤其在版式复杂的文档场景中,视觉元素之间往往存在明确的逻辑先后关系,仅依赖空间顺序可能限制模型对内容结构的理解能力。 DeepSeek-OCR 2 的改进重点在于引入“视觉因果流”Se的概念。在 DeepEncoder V2 中,研究团队用一种类语言模型结构替代了原先基于 CLIP 的视觉编码模块,并在编码器内部引入可学习的“因果流查询 token”。 其编码器同ek时包含双向注意力与因果注意力两种处理模式,原始视觉信息通过双向注意力进行全局感知,而新增的查询标记则通过因果注意力逐步建立语义顺序,从而在编码阶段对视觉 token 的顺 D序进行动态重排。最终,只有经过因果重排后的查询 token 会被送入后续的解码器,用于生成识别结果。 在整体架构上,DeepSeek-OCR 2 仍沿用了前代模型的编解码框架。编ee码器将图像转换为视觉标记并进行压缩,被压缩为较少数量的视觉 token,再由 DeepEncoder V2 进行语义建模和顺序重组,最后交由一个基于混合专家架构(MoE)的语言模型解码pS。 DeepSeek 论文指出,该设计在不显著增加解码负担的前提下,将单页文档所使用的视觉 token 数量控制在 256 到 1120 之间,与前代模型及同类系统的资源开销保持在相ee近水平。 为验证模型性能,研究团队在 OmniDocBench v1.5 基准上进行了全面评估。该基准涵盖多种类型的中英文文档,包括学术论文、杂志、报告等,重点考察文本识别、公式解析、k-表格结构还原以及阅读顺序等指标。 测试结果显示,在视觉 token 上限更低的情况下,DeepSeek-OCR 2 的整体得分达到 91.09%,相较 DeepSeek-OCR 提升了 3.73OC%。特别是在阅读顺序准确度方面,编辑距离从 0.085 降至 0.057,表明新模型能够更合理地理解文档内容结构。 DeepSeek-OCR 2 在生产环境中也表现出更好的稳定性。在R 线用户日志图像的重复率从 6.25% 降至 4.17%,批处理 PDF 数据的重复率从 3.69% 降至 2.88%。这些改进使得模型在保持高压缩率的同时,提升了实际应用场景中的可靠2 性。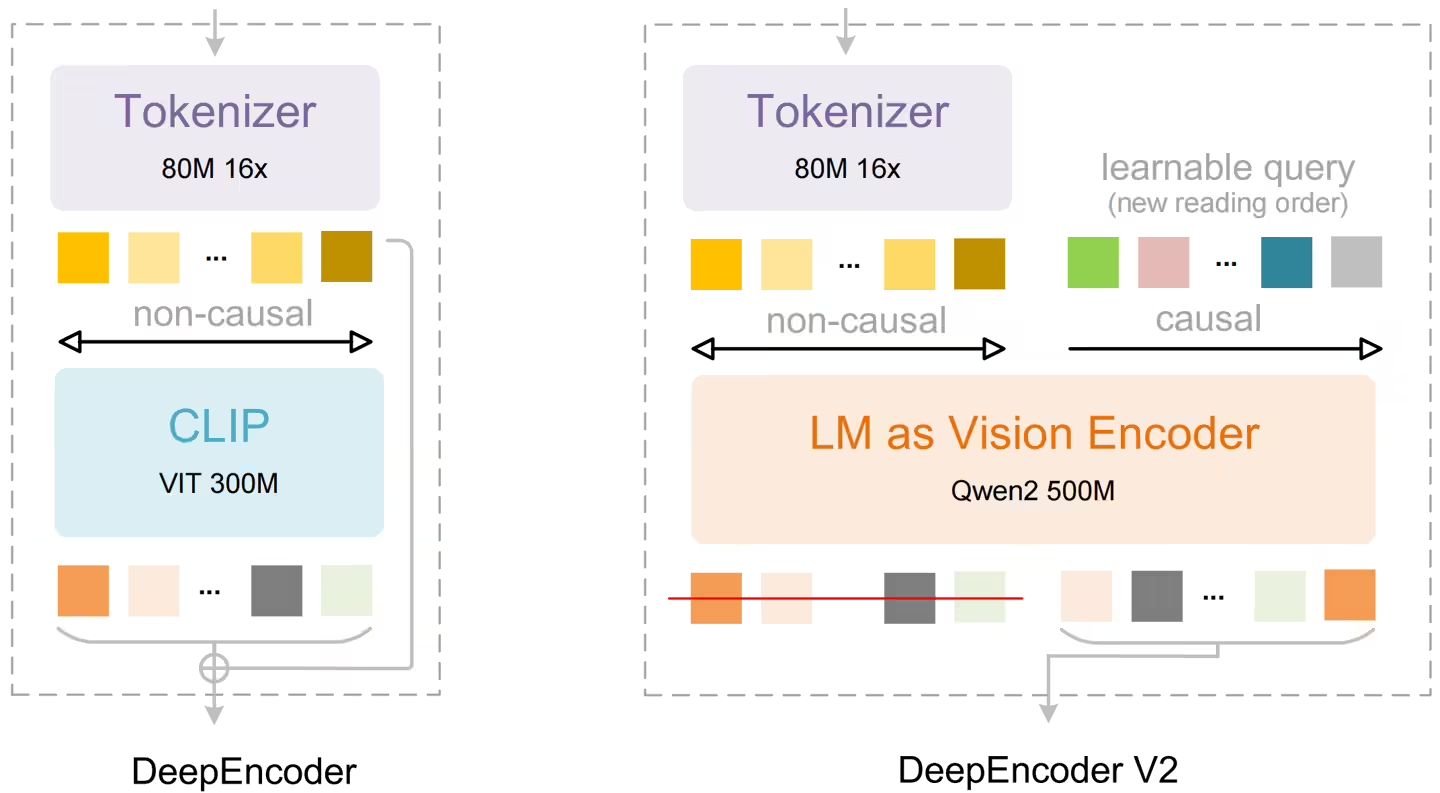
-
上一篇
-
下一篇
- 最近发表
- 随机阅读
-
- 标签: vivo 法务维权 造谣刑事立案 民事诉讼
- 标签: e& Hatem Dowidar Masood Mahmood 电信集团
- Pinterest推出AI内容限制工具:用户可自定义减少生成式AI图像
- 吉祥彩
- 标签: 豆包 Seed2.1 字节跳动 火山引擎
- 自动驾驶初创公司Cruise获微软等20亿美元投资 估值达300亿美元
- 标签: DeepSeek 识图模式 ThinkingWithVisualPrimitives 多模态模型
- 英伟达推出全模态理解模型 OmniVinci,刷新 SOTA 高出19.05分
- 标签: 理奇智能 宁德时代 比亚迪 锂电设备
- 选举将至 Facebook仅在佐治亚州解除政治广告禁令
- 标签: 团油 加油优惠券 直播带货 黑猫投诉 3152026
- 百度电商引入大模型,重塑风控审核流程,商家用户双赢!
- Claude Code网页版重磅来袭!无需CLI,AI编程助手直击云端!
- 中国在5G、AI等领域对美国紧追不舍,但设备工艺依旧落后
- 亚马逊10月28日发布三季度财报 云计算营收有望超过160亿美元
- 云原生初体验:在K8s上部署Springboot应用
- 云计算开发实例:Python3获取几天前的时间
- 浅谈:什么是云网络?
- 标签: 小鹏汽车 大众汽车 欧洲工厂 辅助驾驶
- 标签: SK海力士 EUV光刻胶 东进世美肯 半导体材料
- 搜索
-
- 友情链接